ESB, microservices et e-commerce : retour d'expérience
 · 16 min
Contexte
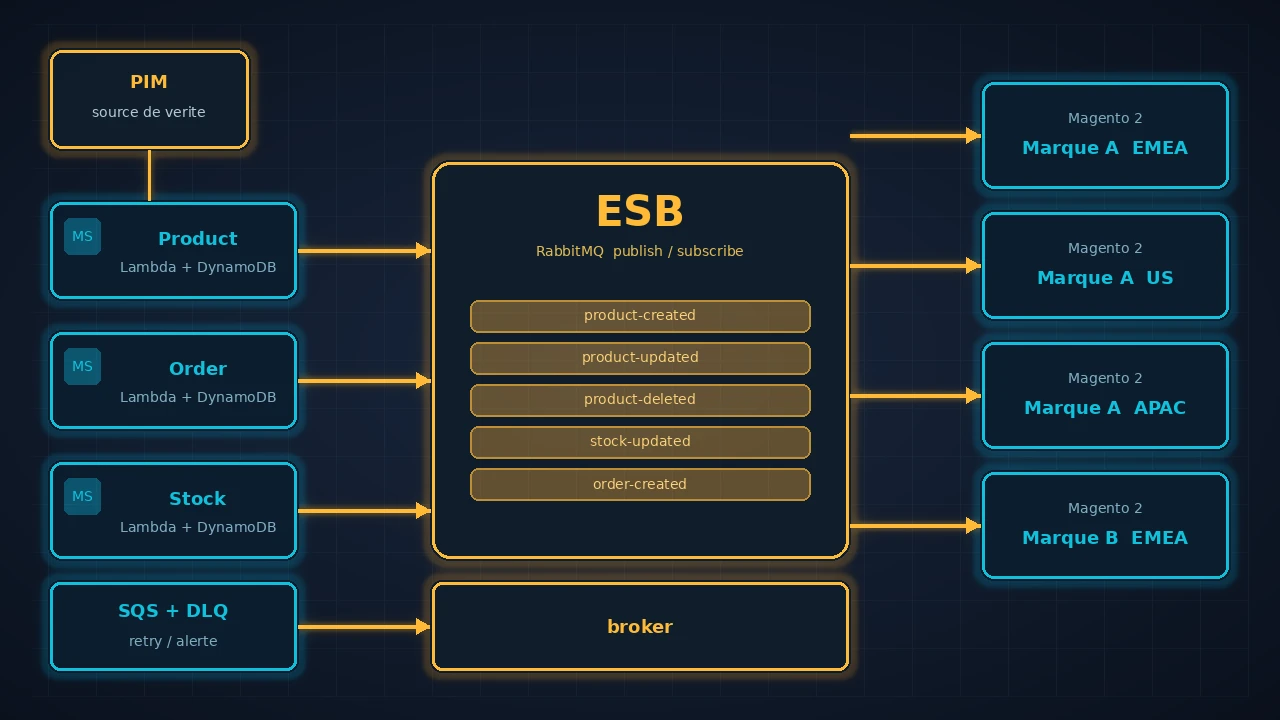
Le projet : une plateforme e-commerce multi-marques et multi-régions. Chaque marque dispose de ses propres sites Magento 2, déclinés par zone géographique: APAC, EMEA, États-Unis. En parallèle, un ensemble de microservices AWS gèrent les données métier : catalogue produits, commandes, stocks, clients.
Le défi est classique mais concret : comment faire circuler l’information de façon fiable entre des systèmes hétérogènes, sans créer de couplage fort, sans point de défaillance unique, et avec la capacité de rejouer des événements en cas de besoin ?
La réponse a été la mise en place d’un Enterprise Service Bus, avec une convention de nommage stricte des topics et une authentification machine-to-machine via OAuth2.
Le PIM : source de vérité des données produits
Au cœur de cette architecture se trouve un PIM (Product Information Management). C’est lui qui détient la source de vérité pour toutes les données produits : références, descriptions, prix, médias, attributs métier. Toutes les applications, microservices et sites Magento, dérivent leurs données produits de ce système.
Le PIM n’écrit pas directement dans les bases de données des microservices ni dans les catalogues Magento. Il communique exclusivement via l’API REST du Product Service, qui est le seul point d’entrée autorisé pour les mutations produits. C’est également le PIM qui génère le correlationId de chaque opération, puisque c’est lui l’initiateur de la chaîne d’événements.
Ce cloisonnement a deux conséquences importantes :
- Cohérence : il n’existe qu’une seule façon de créer ou modifier un produit dans le système. Il n’y a pas de chemin détourné qui pourrait désynchroniser les données.
- Traçabilité : chaque modification produit visible sur un site Magento peut être remontée jusqu’à une action précise dans le PIM, via le
correlationId.
Vue d’ensemble de l’architecture
graph TD
    PIM["PIM\n(source de vérité produits)"]

    subgraph AWS ["AWS: Microservices"]
        PMS["Product Service (Lambda + DynamoDB)"]
        OMS["Order Service (Lambda + DynamoDB)"]
        STOCK["Stock Service (Lambda + DynamoDB)"]
        S3["S3 (assets, exports)"]
        SQS["SQS + DLQ"]
    end

    subgraph ESB ["ESB"]
        BROKER["Broker"]
        TOPICS["Topics : product-created / product-updated / product-deleted / stock-updated / ..."]
    end

    subgraph MAGENTO ["Magento 2: Sites e-commerce"]
        M_EU_A["Marque A: EMEA"]
        M_US_A["Marque A: US"]
        M_APAC_A["Marque A: APAC"]
        M_EU_B["Marque B: EMEA"]
    end

    PIM -->|API REST| PMS
    PMS -->|publie| BROKER
    OMS -->|publie| BROKER
    STOCK -->|publie| BROKER
    BROKER --> TOPICS
    TOPICS -->|souscription| M_EU_A
    TOPICS -->|souscription| M_US_A
    TOPICS -->|souscription| M_APAC_A
    TOPICS -->|souscription| M_EU_B
    SQS -.->|retry / DLQ| PMS
L’ESB : RabbitMQ comme broker de messages
Un Enterprise Service Bus est un composant central qui orchestre les échanges entre des systèmes hétérogènes. Plutôt que de multiplier les connexions point à point entre chaque microservice et chaque site Magento, l’ESB joue le rôle d’intermédiaire : les producteurs publient des messages, les consommateurs souscrivent aux topics qui les intéressent.
Le broker retenu est RabbitMQ. Il offre le support natif des échanges de type topic, une gestion fine des Dead Letter Queues, et une interface d’administration qui facilite le monitoring et le debug en production.
Les échanges reposent sur le modèle publish / subscribe :
- Les microservices AWS sont les producteurs : ils publient des événements métier sur le broker.
- Les sites Magento 2 sont les consommateurs : ils souscrivent aux topics qui les concernent et traitent les messages de façon autonome.
Aucun des deux ne connaît l’autre directement. Le couplage se limite au contrat du message, son format JSON et la convention de nommage des topics.
La convention de nommage des topics : {scope}-{action}
La première décision structurante du projet a été de définir une convention de nommage claire et universelle pour les topics de l’ESB.
Le format retenu : {scope}-{action}
| Topic | Description |
|---|---|
product-created |
Un produit a été créé dans le PIM |
product-updated |
Les données d’un produit ont changé |
product-deleted |
Un produit a été supprimé |
order-created |
Une commande a été passée |
stock-updated |
Le stock d’un SKU a été mis à jour |
customer-merged |
Deux comptes client ont été fusionnés |
Cette convention présente plusieurs avantages :
- Lisibilité immédiate : un développeur qui découvre le système comprend au premier coup d’œil ce que transporte chaque topic.
- Prévisibilité : ajouter un nouveau domaine métier ne nécessite pas de réunion pour décider du nommage, la règle s’applique mécaniquement.
- Découplage producteur / consommateur : un site Magento qui souscrit à
product-updatedn’a aucune connaissance du microservice qui publie. Il consomme un contrat, pas une implémentation.
Chaque message publié sur un topic embarque un payload JSON normalisé : un identifiant unique de l’événement, un timestamp, le scope, l’action, et les données métier associées.
{
  "eventId": "01HX4Z2K8VQWJN3P5T6Y7A9B0C",
  "correlationId": "7f3a1b2c-4d5e-6f7a-8b9c-0d1e2f3a4b5c",
  "occurredAt": "2024-11-14T10:32:00Z",
  "scope": "product",
  "action": "updated",
  "payload": {
    "sku": "PROD-00142",
    "name": "Veste imperméable - Édition automne",
    "price": 189.00,
    "currency": "EUR"
  }
}
Le CorrelationId : traçabilité de bout en bout
Dans un système distribué, une action métier peut déclencher une cascade de messages : un produit mis à jour côté PIM génère un événement product-updated, qui est consommé par plusieurs sites Magento, qui à leur tour mettent à jour leur catalogue, déclenchent des revalidations de cache, etc.
Sans mécanisme de traçabilité, retrouver l’origine d’un problème dans cette chaîne revient à chercher une aiguille dans une botte de foin.
La solution retenue est le CorrelationId : un identifiant unique généré par le publisher au moment de la publication du message initial. Cet identifiant est ensuite propagé dans tous les messages dérivés et dans tous les logs tout au long de la chaîne de traitement.
sequenceDiagram
    participant PIM as PIM / API
    participant MS as Microservice (Lambda)
    participant ESB as ESB
    participant M_A as Magento: Marque A
    participant M_B as Magento: Marque B

    Note over PIM: corrId = uuid()
    PIM->>MS: PUT /products/PROD-00142 (correlationId: corrId)
    MS->>ESB: product-updated (correlationId: corrId)
    ESB->>M_A: product-updated (correlationId: corrId)
    ESB->>M_B: product-updated (correlationId: corrId)
    Note over M_A: log corrId à chaque étape
    Note over M_B: log corrId à chaque étape
Ce que ça change concrètement
Lorsqu’un site Magento signale un problème de synchronisation sur un produit, la première question est : quel message a déclenché cet état ? Avec le correlationId, la réponse tient en une requête dans les logs :
correlationId = "7f3a1b2c-4d5e-6f7a-8b9c-0d1e2f3a4b5c"
On retrouve immédiatement :
- le message original publié par le microservice
- tous les consommateurs qui l’ont reçu
- l’état de traitement sur chacun d’eux (ACK, NACK, retry, DLQ)
Règles d’implémentation
- Le
correlationIdest généré une seule fois, par le publisher du message initial. Il n’est jamais régénéré en cours de route. - Si un consommateur publie lui-même un nouveau message en réaction (chaîne d’événements), il réutilise le même
correlationId, il ne crée pas le sien. - Chaque composant, microservice, module Magento, logue le
correlationIden début de traitement, ce qui permet de filtrer l’ensemble d’une trace dans n’importe quel outil de log.
Authentification machine-to-machine avec OAuth2
Aucun utilisateur humain n’intervient dans ces échanges. Toutes les communications sont machine-to-machine (M2M) : un microservice publie, un site Magento consomme. La notion d’utilisateur est absente.
L’authentification repose sur le flux Client Credentials d’OAuth2.
sequenceDiagram
    participant MS as Microservice (Lambda)
    participant AUTH as Authorization Server
    participant ESB as ESB

    MS->>AUTH: POST /token (client_id + client_secret + grant_type=client_credentials)
    AUTH-->>MS: access_token (JWT)
    MS->>ESB: Publish message with Bearer token
    ESB-->>MS: ACK
Chaque acteur du système, chaque microservice, chaque site Magento, possède ses propres client_id / client_secret et des scopes OAuth2 qui définissent précisément ce qu’il est autorisé à faire :
esb:publish, droit de publier des messages sur le brokeresb:subscribe:product, droit de souscrire aux topics du domaineproductesb:subscribe:order, droit de souscrire aux topics du domaineorder
Cela garantit qu’un site Magento ne peut pas publier de messages à la place d’un microservice, et qu’un microservice ne peut pas souscrire à des topics qui ne le concernent pas.
Les tokens sont mis en cache côté client pour éviter un appel à l’Authorization Server à chaque message. Un token expiré déclenche un renouvellement transparent.
Les microservices AWS
Les microservices sont écrits en TypeScript / Node.js et déployés sur AWS avec le Serverless Framework. Chaque service est indépendant, son propre dépôt, son propre serverless.yml, son propre cycle de déploiement. Un changement sur le Product Service n’implique aucun redéploiement des autres services.
Serverless Framework
Le Serverless Framework est l’outil qui orchestre le déploiement de l’ensemble des ressources AWS. Un fichier serverless.yml par service décrit les fonctions Lambda, les routes API Gateway, les queues SQS, les tables DynamoDB et les permissions IAM associées. Au moment du déploiement, le framework génère et applique un stack CloudFormation complet.
# Extrait serverless.yml - Product Service
service: product-service

provider:
  name: aws
  runtime: nodejs20.x
  region: eu-west-1
  environment:
    PRODUCTS_TABLE: !Ref ProductsTable
    ESB_QUEUE_URL: !Ref EsbPublishQueue

functions:
  updateProduct:
    handler: src/handlers/updateProduct.handler
    events:
      - http:
          path: /products/{sku}
          method: put
          authorizer: aws_iam

  publishToEsb:
    handler: src/handlers/publishToEsb.handler
    events:
      - sqs:
          arn: !GetAtt EsbPublishQueue.Arn
          batchSize: 10

resources:
  Resources:
    ProductsTable:
      Type: AWS::DynamoDB::Table
      Properties:
        TableName: products
        BillingMode: PAY_PER_REQUEST
        AttributeDefinitions:
          - AttributeName: sku
            AttributeType: S
        KeySchema:
          - AttributeName: sku
            KeyType: HASH

    EsbPublishQueue:
      Type: AWS::SQS::Queue
      Properties:
        RedrivePolicy:
          maxReceiveCount: 3
          deadLetterTargetArn: !GetAtt EsbPublishDlq.Arn

    EsbPublishDlq:
      Type: AWS::SQS::Queue
Les composants AWS
API Gateway expose les endpoints REST de chaque microservice. Il gère l’authentification des appels entrants et route les requêtes vers la fonction Lambda correspondante. Chaque service dispose de ses propres routes, versionées indépendamment.
Lambda est le runtime d’exécution. Chaque handler est une fonction TypeScript stateless, déclenchée soit par un appel HTTP via API Gateway, soit par un message SQS. L’absence de serveur à maintenir simplifie considérablement les opérations : scaling automatique, pas de gestion de capacité.
DynamoDB stocke les données métier de chaque service. Le modèle NoSQL orienté clé-valeur correspond bien aux accès unitaires par identifiant (SKU produit, ID commande) qui représentent la grande majorité des requêtes. Le mode PAY_PER_REQUEST évite le surprovisionnement.
SQS joue le rôle de tampon entre le handler HTTP et la publication vers l’ESB. Lorsqu’une Lambda traite une requête entrante, elle enqueue le message dans SQS avant de répondre au client. Une seconde Lambda, déclenchée par SQS, se charge de la publication effective vers le broker. Ce découplage garantit que l’API reste rapide et que les échecs de publication n’impactent pas le client.
SQS Dead Letter Queue (DLQ) : après un nombre configurable d’échecs (ici 3 tentatives), le message est transféré dans une queue dédiée. Une alarme CloudWatch surveille la DLQ et alerte l’équipe dès qu’un message y atterrit. Cela transforme les erreurs silencieuses en incidents visibles et traitables.
graph LR
    APIGW["API Gateway"] -->|invoke| H1["Lambda\nupdateProduct"]
    H1 -->|write| DB["DynamoDB"]
    H1 -->|enqueue| SQS["SQS"]
    SQS -->|trigger| H2["Lambda\npublishToEsb"]
    H2 -->|publish| ESB["ESB"]
    SQS -->|échec x3| DLQ["DLQ"]
    DLQ -->|alerte| CW["CloudWatch Alarm"]
Flux de publication d’un événement
Lorsqu’un produit est mis à jour via l’API d’un microservice, le flux est le suivant :
sequenceDiagram
    participant CLIENT as Client externe
    participant APIGW as API Gateway
    participant LAMBDA as Lambda (Product Service)
    participant DYNAMO as DynamoDB
    participant SQS as SQS
    participant ESB as ESB

    CLIENT->>APIGW: PUT /products/PROD-00142
    APIGW->>LAMBDA: invoke
    LAMBDA->>DYNAMO: update item
    DYNAMO-->>LAMBDA: OK
    LAMBDA->>SQS: enqueue publish event
    SQS-->>LAMBDA: OK
    LAMBDA-->>APIGW: 200 OK
    APIGW-->>CLIENT: 200 OK
    SQS->>LAMBDA: trigger (async)
    LAMBDA->>ESB: publish product-updated
La publication sur l’ESB est découplée de la réponse HTTP via SQS. Cela garantit que l’API reste rapide et que la publication sur le broker ne bloque pas la réponse au client. En cas d’échec de publication, le message part en Dead Letter Queue pour analyse et rejeu.
Les sites Magento 2 : consommateurs de l’ESB
Chaque site Magento 2 est un consommateur autonome. Il souscrit uniquement aux topics qui le concernent et traite les messages de façon indépendante.
Un module Magento dédié gère :
- La connexion au broker
- Le renouvellement du token OAuth2
- La désérialisation et la validation des payloads JSON
- L’application des changements dans le catalogue Magento (produits, prix, stocks)
- L’acquittement (ACK) ou le rejet (NACK) des messages
Si le traitement d’un message échoue (erreur de validation, problème de base de données), le message est nack’d et remis en queue pour un nouveau traitement après un délai exponentiel.
graph LR
    ESB["ESB : product-updated"] -->|message| MODULE["Module Magento Consumer"]
    MODULE -->|parse + validate| PROCESS["Traitement métier"]
    PROCESS -->|succès| ACK["ACK"]
    PROCESS -->|échec| NACK["NACK (retry)"]
    NACK -->|max retries atteint| DLQ["Dead Letter Queue"]
La subscription aux topics
Chaque site Magento souscrit explicitement aux topics qui le concernent. Un site EMEA de la marque A n’a aucune raison de recevoir des événements destinés à la marque B.
La subscription est déclarée dans la configuration du module Magento et reflète les scopes OAuth2 accordés à ce site :
Marque A - EMEA :
  ✓ product-created
  ✓ product-updated
  ✓ product-deleted
  ✓ stock-updated
  ✗ order-created  (géré en interne par Magento)

Marque B - US :
  ✓ product-created
  ✓ product-updated
  ✓ product-deleted
  ✓ stock-updated
  ✓ customer-merged
Cette granularité permet de réduire la charge sur chaque site : un consommateur ne traite que ce qu’il doit traiter. Elle facilite aussi le debug, si un site a un problème de synchronisation, on sait exactement quels topics inspecter.
Le full replay : resynchronisation complète du catalogue
L’une des fonctionnalités les plus utiles du système est la capacité à rejouer l’intégralité des messages d’un topic pour un ou plusieurs consommateurs.
Cas d’usage concrets
- Un nouveau site Magento est déployé pour une nouvelle région : il a besoin de l’intégralité du catalogue produits, qui ne sera pas republié naturellement car les produits n’ont pas changé.
- Un bug dans le module Magento a corrompu une partie du catalogue d’un site. Plutôt que de corriger manuellement, on relance un full replay.
- Une migration de base de données côté Magento nécessite de réimporter toutes les données depuis la source de vérité.
Mécanisme
Le full replay est déclenché via une API dédiée exposée par le microservice concerné. Exemple pour le catalogue produits :
POST /products/replay
{
  "targets": ["magento-brand-a-emea"],
  "since": null
}
Le microservice :
- Pagine l’intégralité des produits stockés dans DynamoDB
- Pour chaque produit, publie un événement
product-updatedsur le topic de l’ESB, avec un flagreplay: truedans le payload - Les consommateurs Magento traitent ces événements exactement comme des mises à jour normales
sequenceDiagram
    participant OPS as Opérateur
    participant API as API Gateway /products/replay
    participant LAMBDA as Lambda (Replay Handler)
    participant DYNAMO as DynamoDB
    participant ESB as ESB

    OPS->>API: POST /products/replay
    API->>LAMBDA: invoke
    loop Pour chaque page de produits
        LAMBDA->>DYNAMO: scan page
        DYNAMO-->>LAMBDA: items[]
        LAMBDA->>ESB: publish product-updated (replay: true) x N
    end
    LAMBDA-->>API: 202 Accepted
Le flag replay: true dans le payload permet aux consommateurs, s’ils le souhaitent, d’adapter leur comportement : par exemple, ne pas déclencher certaines notifications client lors d’un replay.
Le full replay peut être partiel : on peut rejouer uniquement les produits créés après une date donnée (since), ou uniquement pour certains consommateurs (targets).
Ce que ce projet m’a appris
La convention de nommage est une décision d’architecture. Définir {scope}-{action} dès le départ a évité des dizaines de discussions futures sur le nommage des topics. Une règle simple, appliquée systématiquement, vaut mieux qu’une liste de topics ad hoc.
L’authentification M2M doit être pensée dès le début. Ajouter OAuth2 après coup sur un ESB en production est coûteux. L’avoir posé comme prérequis dès le départ a forcé chaque intégration à être propre et traçable.
Le full replay change la relation au risque. Savoir qu’on peut resynchroniser n’importe quel site à tout moment réduit considérablement la pression sur les mises en production et les migrations. C’est un filet de sécurité opérationnel autant qu’une fonctionnalité technique.
SQS entre Lambda et l’ESB est le bon découplage. Sans cette couche intermédiaire, un pic de charge ou une indisponibilité temporaire du broker impacterait directement les temps de réponse des APIs. Avec SQS, l’API répond toujours vite, et le broker absorbe la charge à son rythme.
La DLQ est une fonctionnalité, pas un détail. Avoir une Dead Letter Queue avec des alertes et un outillage de rejeu ciblé transforme les erreurs de traitement en incidents gérables plutôt qu’en données perdues silencieusement.
Conclusion
Mettre en place un ESB sur ce type de projet, multi-marques, multi-régions, systèmes hétérogènes, a permis de découpler durablement les producteurs des consommateurs, de standardiser les échanges, et de donner aux équipes opérationnelles des leviers concrets pour gérer les incidents et les montées de version.
Ce n’est pas une architecture universelle. Elle a un coût en complexité opérationnelle (broker à opérer, tokens à gérer, conventions à documenter). Mais dans un contexte où les flux de données sont nombreux et les acteurs multiples, c’est un investissement qui se rentabilise rapidement.